Die Geschichte von DeepSeek
Vom Quant-Fonds High-Flyer über den „R1-Schock“ bis DeepSeek-V4-Pro — Modelle, Effizienz und Kontroversen.
Die Chronik in Kapiteln
Rauten sind Schlüsselmomente. Ein Klick springt zur Stelle in der Zeitleiste; beim Scrollen läuft die Marke mit.
Köpfe
Der Gründer, der DeepSeek aus einem Hedgefonds heraus aufgebaut hat und bis heute führt. Porträts nur mit freier Lizenz; wo keine existiert, steht das Schriftzeichen.
Liang Wenfeng 梁文锋
Gründer, CEO seit 2023Gründete 2015 mit Kommilitonen den KI-gesteuerten Hedgefonds High-Flyer in Hangzhou und ließ dort die Fire-Flyer-GPU-Cluster bauen. 2023 gliederte er daraus DeepSeek aus, das er als CEO führt und bis 2026 ohne externe Investoren finanzierte.
Konfidenz-Kennzeichnung
- ✅ Faktum (belegt)
- 🟡 teilweise belegt
- 🔵 Interpretation
Kategorien
- Unternehmen
- Forschung
- Sicherheit
- Modell
- Produkt
- Kontroverse
Zeitleiste
Fünf Kapitel von High-Flyer bis V4.1-Flash, IPO-Vorbereitung und dem Schwenk auf Huawei-Chips. Filtere nach Kategorie oder durchsuche alle Ereignisse — jeder Eintrag führt seine Quellen mit.
Die Vorgeschichte: High-Flyer
Vom KI-Quant-Fonds High-Flyer zu eigenen GPU-Clustern.
Gründung des Quant-Fonds High-Flyer
Liang Wenfeng gründet mit Kommilitonen den KI-getriebenen Hedgefonds High-Flyer (幻方) in Hangzhou. Ende 2017 laufen laut Firmengeschichte fast alle Handelsstrategien über KI-Modelle; der Fonds verwaltet zeitweise rund 10 Mrd. USD.
Fire-Flyer: eigene GPU-Supercomputer
High-Flyer baut eigene KI-Cluster auf: Fire-Flyer I (2020, 1.100 GPUs) und Fire-Flyer II (2021) mit rund 10.000 Nvidia-A100-GPUs — laut Liang allesamt erworben, bevor die USA Chip-Exportkontrollen verhängten. Diese Rechenbasis ermöglicht später alle DeepSeek-Trainingsläufe.
Gründung & erste Modelle
DeepSeek wird eigenständig — Coder und die ersten Sprachmodelle.
High-Flyer kündigt AGI-Labor an
High-Flyer gibt die Gründung eines eigenen Forschungslabors für Artificial General Intelligence bekannt — ausdrücklich nicht für den Aktienhandel. Es ist der unmittelbare Vorläufer von DeepSeek.
Gründung von DeepSeek
Das AGI-Labor wird als eigenständige Hangzhou DeepSeek (深度求索) ausgegliedert, mit Liang Wenfeng als CEO. Finanziert allein durch High-Flyer, ohne externe Investoren. Liangs Leitlinie: Grundlagenforschung und Open Source vor schneller Kommerzialisierung.
DeepSeek Coder (erstes Open-Source-Modell)DeepSeek Coder
DeepSeeks erstes Modell erscheint quelloffen auf GitHub und richtet sich speziell an Code-Aufgaben — in mehreren Größen und unter freier Lizenz.
DeepSeek LLM 7B/67BDeepSeek LLM 67B
Die ersten allgemeinen Sprachmodelle (7B und 67B), trainiert auf 2 Billionen Tokens (Englisch/Chinesisch). Das 67B-Modell übertrifft in frühen Benchmarks Llama 2 70B bei Reasoning, Coding und Mathematik.
Architektur-Durchbrüche & V3
MLA, der Preiskrieg und das effiziente Flaggschiff V3.
DeepSeek-V2 löst Chinas Preiskrieg ausDeepSeek-V2
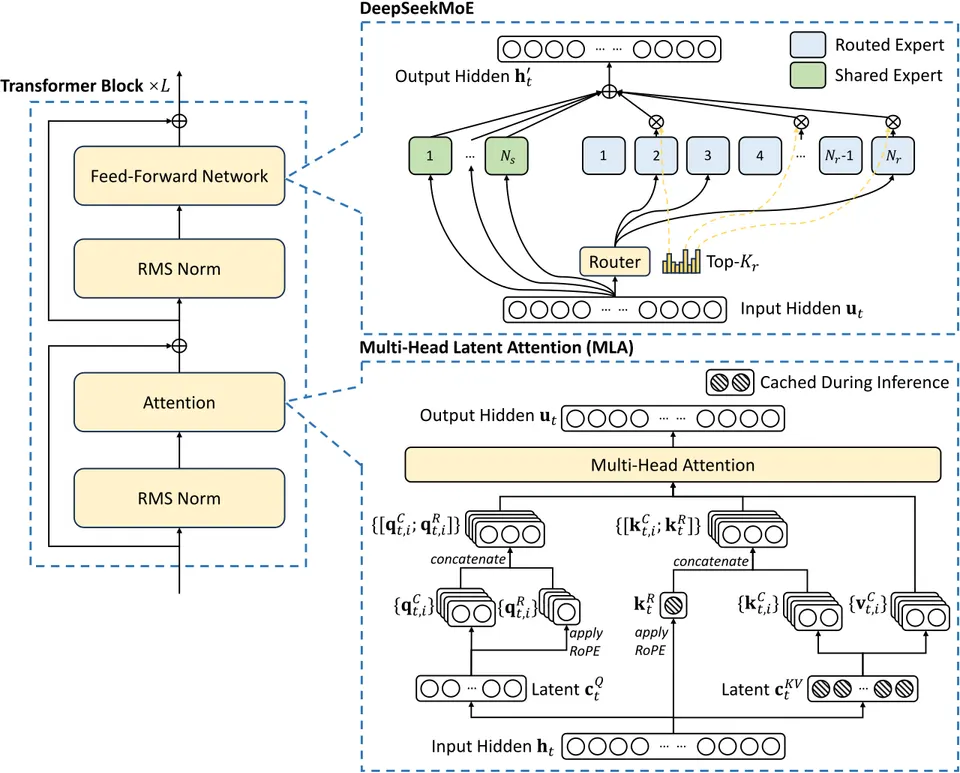
DeepSeek-V2 (236B gesamt, 21B aktiv) führt Multi-head Latent Attention (MLA) und DeepSeekMoE ein und senkt Kosten drastisch. Der API-Preis liegt 90–95 % unter der Konkurrenz; Alibaba, Baidu und ByteDance senken daraufhin ihre Preise um bis zu 97 % — ein Preiskrieg in Chinas KI-Branche.
DeepSeek-Coder-V2DeepSeek-Coder-V2
Ein offenes MoE-Coding-Modell (bis 236B), das 338 Programmiersprachen und 128K-Kontext unterstützt und in Code-Benchmarks GPT-4-Turbo-Niveau erreicht.
DeepSeek-V2.5DeepSeek-V2.5
V2.5 vereint Chat- und Coder-V2-Fähigkeiten in einem Modell, mit besserer Konversation und Code-Verarbeitung und stärkerer Ausrichtung an menschlichen Präferenzen.
Der stille Auslöser: Frontier-Leistung zu einem Bruchteil der üblichen Kosten.
DeepSeek-V3 — Frontier-Leistung zum Bruchteil der KostenDeepSeek-V3
Das 671B-MoE-Modell (37B aktiv, 14,8 Bio. Tokens) erreicht GPT-4o-/Claude-3.5-Niveau. Der Bericht weist nur ~5,576 Mio. USD reine GPU-Trainingskosten aus (Kritiker: Gesamtkosten viel höher). Die Effizienz wird zum Weckruf für die Branche.
DeepSeek-V3 (671B MoE, 37B aktiv) erreichte das Niveau von GPT-4o und Claude 3.5 Sonnet, kostete laut Bericht aber nur ~5,576 Mio. USD reine GPU-Trainingszeit (2,79 Mio. H800-Stunden). Kritiker betonen, dass Gesamtkosten inklusive Forschung und Infrastruktur weit höher liegen. Dennoch verschob V3 die Wahrnehmung, was Spitzen-KI kosten muss.
Im Kapitel weiterlesen →Der R1-Schock & die Folgen
R1, das Börsenbeben, Verbote — und die Reife der Modellreihe.
Offen, günstig, auf o1-Niveau — das Modell, das den Westen aufschrecken ließ.
DeepSeek-R1 — offenes Reasoning-Modell (MIT)DeepSeek-R1
R1 erreicht laut DeepSeek das Niveau von OpenAI o1 bei Mathematik, Code und Logik — und wird mitsamt Gewichten unter MIT-Lizenz freigegeben. Die Variante R1-Zero zeigt erstmals großskaliges Reasoning aus reinem Reinforcement Learning (GRPO), dazu destillierte Modelle von 1,5B bis 70B.
R1 erreichte bei Mathematik, Code und Logik OpenAI-o1-Niveau — und wurde mitsamt Gewichten unter MIT-Lizenz freigegeben. Die Variante R1-Zero zeigte, dass starkes Reasoning auch aus reinem Reinforcement Learning ohne Supervised Fine-Tuning entstehen kann. Innerhalb von Tagen stürmte die App weltweit an die Spitze der App-Stores.
Im Kapitel weiterlesen →Janus-Pro — multimodale offene ModelleJanus-Pro
Zum Mondneujahr veröffentlicht DeepSeek die multimodalen Modelle Janus-Pro (1B/7B) und JanusFlow unter MIT-Lizenz; sie übertreffen auf Bild-Benchmarks DALL·E 3 und Stable Diffusion 3 Medium.
DeepSeek-App überholt ChatGPT (Platz 1)DeepSeek-R1
Die DeepSeek-App wird zur meistgeladenen Gratis-App im US-App-Store und verdrängt ChatGPT — in 52 Ländern auf Platz 1, ~16 Mio. Downloads in 18 Tagen.
Ein Tag, an dem rund 589 Milliarden Dollar verdampften.
Nvidia verliert ~589 Mrd. USD an einem Tag
DeepSeeks Effizienz löst einen globalen Tech-Ausverkauf aus: Nvidia bricht ~17 % ein und verliert rund 589 Mrd. USD Marktwert — der größte Einzeltagesverlust der US-Börsengeschichte. Marc Andreessen nennt R1 „AIs Sputnik-Moment“.
Am 27. Januar 2025 brach Nvidia um rund 17 % ein und verlor etwa 589 Mrd. USD Marktwert — der größte Einzeltagesverlust der US-Börsengeschichte. Anleger fragten, ob teure KI-Chips im bisherigen Umfang noch nötig seien. Marc Andreessen prägte den Vergleich vom „Sputnik-Moment“ der KI.
Im Kapitel weiterlesen →Cyberangriff: DeepSeek stoppt Neuregistrierungen
Mitten im Ansturm trifft DeepSeek ein groß angelegter DDoS-Angriff in mehreren Wellen; das Unternehmen stoppt vorübergehend neue Registrierungen.
Distillations-Vorwurf von OpenAI/MicrosoftDeepSeek-R1
Microsoft und OpenAI untersuchen, ob mit DeepSeek verbundene Akteure per „Distillation“ in großem Umfang OpenAI-API-Ausgaben abgegriffen haben, um eigene Modelle zu trainieren.
Offene Datenbank: Chatverläufe & Schlüssel exponiert
Wiz Research entdeckt eine öffentlich erreichbare DeepSeek-Datenbank ohne Authentifizierung mit über 1 Mio. Log-Einträgen — inklusive Klartext-Chats und API-Schlüsseln. DeepSeek sichert sie nach der Meldung.
Italien sperrt DeepSeek (erstes Land)
Die Datenschutzbehörde Garante ordnet die sofortige Sperrung an, nachdem DeepSeek auf Fragen zu Datenpraktiken und Speicherung in China „unzureichend“ antwortete — das erste Notfall-DSGVO-Verbot gegen einen KI-Chatbot.
US-Behörden verbieten DeepSeek
US Navy (24.1.), NASA und Texas (31.1., erster Bundesstaat) untersagen DeepSeek auf Dienstgeräten; weitere Behörden und Bundesstaaten folgen — begründet mit Sicherheits- und Datenschutzbedenken.
Brillante Technik trifft auf die roten Linien der chinesischen Politik.
Zensur politisch sensibler ThemenDeepSeek-R1
Recherchen zeigen: Die DeepSeek-App verweigert rund 85 % der Fragen zu sensiblen Themen (Tiananmen, Taiwan, Xi, Uiguren) oder löscht begonnene Antworten in Echtzeit — entlang chinesischer Vorgaben.
Untersuchungen zeigten, dass die DeepSeek-App rund 85 % der Fragen zu sensiblen Themen wie dem Tiananmen-Massaker, Taiwan oder Xi Jinping verweigerte — teils, indem sie begonnene Antworten in Echtzeit wieder löschte. Taiwan wurde als „unveräußerlicher Teil Chinas“ dargestellt. Die Filter folgen chinesischen Vorgaben und gelten vielen als Preis der staatlichen Einbettung.
Im Kapitel weiterlesen →Taiwan, Australien & Südkorea verbieten DeepSeek
Taiwan untersagt den Behördeneinsatz (31.1.), Australien verbietet die App auf Regierungsgeräten (4.2.), Südkorea entfernt sie aus den App-Stores (15.2.) — wegen Datenschutz- und Sicherheitsbedenken.
Liang Wenfeng beim Xi-Symposium
Liang nimmt an Xi Jinpings Symposium mit Privatunternehmern teil — neben Jack Ma und Ren Zhengfei. Die Einladung gilt als implizite staatliche Anerkennung DeepSeeks.
DeepSeek-V3-0324 (großes Update)DeepSeek-V3-0324
Ein V3-Checkpoint mit R1-Reasoning-Techniken springt deutlich in Mathematik und Code (AIME 39,6→59,4) und gilt als erstes Open-Source-Modell, das proprietäre Nicht-Reasoning-Modelle wie GPT-4.5 dort übertrifft.
DeepSeek-R1-0528 (Reasoning-Update)DeepSeek-R1-0528
Das R1-Update verdoppelt die Denk-Tiefe (mehr Reasoning-Tokens), hebt AIME-2025 von 70 % auf 87,5 % und senkt Halluzinationen deutlich; neu sind JSON-Output und Function Calling.
EU-Untersuchungen; Deutschland fordert App-Store-Bann
Mehrere EU-Behörden (Frankreich, Irland, Belgien, Niederlande) prüfen DeepSeeks Datentransfers nach China; Berlins Datenschutzbeauftragte fordert Apple und Google auf, die App aus deutschen Stores zu entfernen.
R2 verzögert sich (Huawei-Chip-Probleme)DeepSeek-R2
Berichten zufolge verschiebt sich das erwartete DeepSeek-R2, weil ein voller Trainingslauf auf Huawei-Ascend-Chips misslingt. Als Kompromiss wird Nvidia fürs Training und Ascend für Inferenz genutzt.
DeepSeek-V3.1 (hybrides Reasoning)DeepSeek-V3.1
V3.1 (671B, 128K Kontext) lässt sich per Vorlage zwischen Thinking-Modus (Chain-of-Thought wie R1) und Non-Thinking-Modus (direkt wie V3) umschalten; Gewichte unter MIT.
Erstmals besteht ein großes offenes Modell ein wissenschaftliches Peer-Review.
DeepSeek-R1 auf dem Nature-CoverDeepSeek-R1
R1 wird in Nature publiziert — das erste große Open-Weight-Modell, das ein Peer-Review durchläuft. Offengelegt: die reinen R1-Reasoning-Trainingskosten von 294.000 USD (512 H800, ~80 Std.) auf Basis des ~6-Mio.-USD-V3.
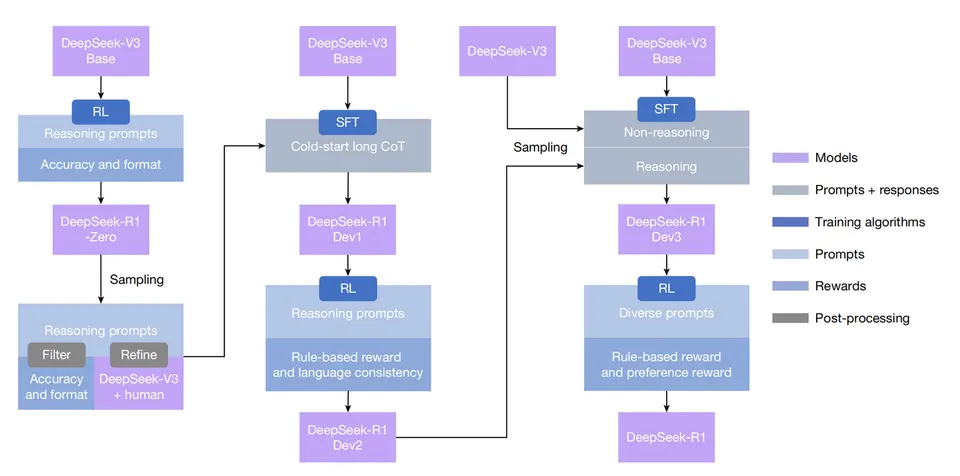
Im September 2025 erschien R1 in Nature — das erste große Open-Weight-Modell, das ein unabhängiges Peer-Review durchlief (acht Gutachter, 64 Seiten). Offengelegt wurden u. a. die reinen Reasoning-Trainingskosten von 294.000 USD (512 H800-GPUs, ~80 Stunden), aufbauend auf dem rund 6 Mio. USD teuren Basismodell V3.
Im Kapitel weiterlesen →DeepSeek-V3.1-TerminusDeepSeek-V3.1-Terminus
Eine produktionsreife Endstufe der V3.1-Reihe: behebt Sprachmisch-Fehler, verbessert mehrsprachige Konsistenz sowie Code- und Such-Agenten.
DeepSeek-V3.2-Exp halbiert die API-PreiseDeepSeek-V3.2-Exp
Mit „DeepSeek Sparse Attention“ (Lightning Indexer + feinkörnige Token-Auswahl) sinken die API-Preise um ~50 % (unter 3 Cent je Mio. Input-Token), bei vergleichbarer Benchmark-Leistung; Gewichte unter MIT.
V4 & Etablierung
V4 wird offiziell, V4.1-Flash eröffnet eine neue Architekturfamilie; dazu IPO-Vorbereitung, 1 Mrd. USD Run-Rate, die zweite Runde bei 500 Mrd. Yuan und der Schwenk auf Huawei-Chips.
Das offene Flaggschiff von 2026 — 1-Mio.-Kontext, zum Spottpreis.
DeepSeek-V4-Preview (1-Mio.-Kontext, Open Source)DeepSeek-V4
V4 erscheint in zwei offenen Varianten: V4-Pro (1,6 Bio. Parameter, 49B aktiv) und V4-Flash (284B, 13B aktiv), beide mit 1-Mio.-Token-Kontext und MIT-Lizenz; Sparse Attention senkt den Inferenzaufwand weiter. MIT Tech Review wertet es als Erfolg auch für Chinas Chip-Industrie.
DeepSeek-V4 erschien als offene Preview in zwei Varianten — V4-Pro (1,6 Bio. Parameter, 49B aktiv) und V4-Flash (284B, 13B aktiv) — beide mit 1-Mio.-Token-Kontext unter MIT-Lizenz. Verbesserte Sparse Attention senkte den Inferenzaufwand weiter. MIT Technology Review wertete den Schritt auch als Erfolg für Chinas heimische Chip-Industrie.
Im Kapitel weiterlesen →Erste Finanzierungsrunde: ~45 Mrd. USD Bewertung
DeepSeek sucht erstmals externes Kapital bei einer Bewertung von rund 45 Mrd. USD; Chinas staatlicher „Big Fund“ soll die Runde anführen, Tencent und Alibaba sind in Gesprächen. Liang Wenfeng hält bislang knapp 90 %.
Erstmals externes Geld — über 7 Mrd. USD, und Liang Wenfeng bleibt Herr im Haus.
Erste Finanzierungsrunde abgeschlossen: >50 Mrd. USD Bewertung
Nach Reuters-Bericht vom 3. Juni schließt DeepSeek seine erste externe Runde ab: rund 50 Mrd. Yuan (~7,4 Mrd. USD) bei 350–400 Mrd. Yuan post-money (~52–59 Mrd. USD). Tencent (~10 Mrd. Yuan) und CATL (~5 Mrd. Yuan) steigen ein, Liang Wenfeng schießt ~20 Mrd. Yuan eigenes Geld zu.
The Information meldete Mitte Juni den Abschluss: mehr als 50 Mrd. Yuan bei einer Bewertung über 50 Mrd. USD. Ungewöhnlich ist die Struktur: Die Investoren stecken ihr Geld in eine von Liang Wenfeng verwaltete Limited Partnership statt direkt in DeepSeek — Tencent, CATL, JD.com und NetEase erhielten den Berichten zufolge keine Stimmrechte, Liang hält rund 84 %. Einziger externer Gesellschafter mit Governance-Rechten ist der staatliche National AI Industry Investment Fund. DeepSeek selbst hat die Runde bis heute nicht offiziell bestätigt.
Aus der Preview wird der offizielle Dienst — mit Peak-Preisen zur Pekinger Rushhour.
V4 verlässt die Preview — alte Aliase abgeschaltet
Mitte Juli wird V4 offiziell: Das Preview-Label fällt, dafür kommen Peak-/Off-Peak-Preise (zur Pekinger Lastspitze 9–12 und 14–18 Uhr das Doppelte). Am 24. Juli werden die Legacy-Aliase „deepseek-chat“ und „deepseek-reasoner“ abgeschaltet — die API läuft komplett auf V4-Pro und V4-Flash.
Die Peak-/Off-Peak-Logik ist typisch DeepSeek: Wer außerhalb der chinesischen Lastspitze inferiert, zahlt die Hälfte — ein Anreiz, der Rechenkapazität glättet und die Preisführerschaft am unteren Ende zementiert. Mit der Alias-Abschaltung endet auch die V2.5/V3-Ära in der API; Bestandskunden mussten auf die V4-Modellnamen migrieren.
Im Kapitel weiterlesen →Der 284B-Flash wird zum Agenten-Arbeitstier — offene Gewichte am selben Tag.
V4-Flash-0731: Agenten- und Coding-SchubDeepSeek-V4-Flash
DeepSeek veröffentlicht den Checkpoint V4-Flash-0731 als offizielles Release in Public Beta — die Gewichte erscheinen am selben Tag auf Hugging Face. Deutliche Zuwächse bei agentischen und Coding-Aufgaben (Terminal-Bench 82,7 %), der Preis bleibt bei $0,14/$0,28 pro Mio. Token.
Der 0731-Checkpoint ersetzt die April-Preview als offizielles V4-Flash: gleiche Architektur (284B MoE, 13B aktiv, MIT), aber agentisch nachgeschärft. Zu $0,14/$0,28 pro Mio. Token liegt der Flash damit um Größenordnungen unter westlichen Frontier-Preisen — in der KI-Modelle-Übersicht steht er beim Artificial-Analysis-Index bei 52.
Im Kapitel weiterlesen →Das 1,6-Bio.-Parameter-Flaggschiff ist fertig — vier Monate nach der Preview.
V4-Pro erreicht GA (Checkpoint 0813)DeepSeek-V4-Pro
V4-Pro geht mit dem Checkpoint DeepSeek-V4-Pro-0813 in General Availability — das Flaggschiff mit 1,6 Bio. Parametern (49B aktiv) und 1-Mio.-Kontext ist damit produktiv verfügbar. Ab 16. August gelten Peak-Preise von $1,32/$3,96 pro Mio. Token, außerhalb der Lastspitze die Hälfte.
Der API-Name „deepseek-v4-pro“ routet seit jeher auf den neuesten Checkpoint — mit 0813 endet die Preview-Phase auch beim Pro. In der KI-Modelle-Übersicht steht V4-Pro 0813 beim Artificial-Analysis-Index bei 53, knapp über dem Flash 0731 (52) — solide Frontier-Nähe, aber hinter den westlichen Spitzenmodellen der Saison (Fable 5.1, GPT-6 Astra).
Im Kapitel weiterlesen →Erstmals multimodal: Der günstige Flash lernt sehen — Gewichte zehn Tage später offen.
V4-Flash-Vision-Exp: Der Flash bekommt AugenV4-Flash-Vision-Exp
Am 21. August erscheint mit „deepseek-v4-flash-vision-exp“ erstmals ein multimodales V4-Modell in der API — experimentell, aber zum selben Preis wie V4-Flash. Am 31. August folgen die Gewichte auf Hugging Face, wieder unter MIT-Lizenz.
Vision-Exp baut auf V4-Flash und behält dessen Textleistung, ergänzt aber Bildverständnis — relevant für Agenten, die Screenshots ihrer Werkzeuge direkt zurück ins Modell schleifen. Praktischer Pfeiler: Bilder werden mit maximal 384 Token veranschlagt. Das „Exp“-Label signalisiert, dass DeepSeek das Modell selbst nicht als produktionsreif einstuft; in der KI-Modelle-Übersicht steht es beim AA-Index bei 51.
Aus dem Nebenprojekt wird ein Geschäft — und die Hardware-Abhängigkeit soll fallen.
~500 Mio. USD Umsatz annualisiert — 2027-IPO und eigener Chip berichtet
Sekundärberichte (auf Reuters gestützt) beziffern DeepSeeks annualisierte Einnahmen auf knapp 500 Mio. USD bei berichteten 70–80 % Bruttomargen; ein IPO 2027 sei in Planung, zugleich stellt DeepSeek Chip-Designer für einen eigenen Inferenz-Chip ein. Das seit Langem erwartete R2 ist Stand September weiter nicht erschienen.
Alle drei Angaben beruhen auf Presseberichten, nicht auf Unternehmensmitteilungen: die Umsatzzahl (~500 Mio. USD annualisiert) und die 2027-IPO-Pläne auf Reuters-basierten Sekundärquellen, die Chip-Pläne auf Stellenanzeigen für Chip-Design-Ingenieure — gelesen als Versuch, die Abhängigkeit von exportkontrollierter Nvidia-Hardware zu verringern. Und R2? Stand September 2026 hat DeepSeek kein R2 veröffentlicht und keinen Termin genannt; die Modelllinie läuft über V4 weiter.
Im Kapitel weiterlesen →Ein neuer Bauplan: Der Encoder liest, der Decoder schreibt, und der Flash sieht jetzt von Haus aus.
DeepSeek-V4.1-Flash: Auftakt einer neuen ArchitekturfamilieDeepSeek-V4.1-Flash
Am 10. September erscheint DeepSeek-V4.1-Flash als erstes Modell einer neuen Architekturfamilie (Causal Encoder-Decoder): 552B Parameter MoE, davon 8B beim Einlesen und 16B beim Antworten aktiv, 1-Mio.-Kontext, Bildverständnis von Haus aus, MIT-Gewichte am selben Tag. Es ersetzt V4-Flash und Vision-Exp; Off-Peak kostet es $0,15/$0,60 pro Mio. Token, zur Peak-Zeit das Doppelte.
Laut Paper (arXiv 2609.19969, 45 Bio. Trainings-Token) drücken Cross-Layer-Wiederverwendung des KV-Caches („Compressed Sparse Attention 2“) und ein FP4-KV-Cache den Speicherbedarf auf rund 890 Byte je Token, etwa ein Viertel des V4-Flash. Benchmarks laut Modellkarte: GPQA Diamond 90,9, HLE 36,8, Codeforces 3471, MathArena Apex 65,6. Die angekündigte Umleitung aller V4-Pro-Anfragen auf den Flash ab 14. September nahm DeepSeek nach Nutzerprotest zurück; V4-Pro läuft mit unveränderten Preisen weiter, ein V4.1-Pro ist angekündigt, aber ohne Termin. In der hauseigenen KI-Modelle-Übersicht steht V4.1-Flash beim Artificial-Analysis-Index (Skala v4.3.2) bei 39, der Flash 0731 auf derselben Skala bei 34.
Aus dem Labor wird eine Firma, die an die Börse kann.
IPO-Vorbereitung: CITIC Securities mandatiert, erster CFO geholt
Reuters berichtet am 9. September, DeepSeek habe CITIC Securities für ein Listing am Shanghaier STAR Market mandatiert; der Prozess soll noch 2026 beginnen, Zeitpunkt, Volumen und Bewertung sind offen. Am 14. September folgt die Meldung, Yan Wentao (GL Ventures, Hillhouse) werde erster Finanzchef. DeepSeek hat beides nicht bestätigt.
Chinesische Börsenkandidaten brauchen vor dem Antrag einen Sponsor für das „Pre-Listing-Tutoring“; das CITIC-Mandat ist also Vorbereitung, kein Antrag. Laut Reuters sieht Liang Wenfeng im Börsengang vor allem ein Vergütungsinstrument, um Forscher zu halten, nachdem Leute zu ByteDance und Xiaomi gewechselt sind. Der designierte CFO, Jahrgang 1991, hat als Investor unter anderem MiniMax begleitet. Zusammen mit der zweiten Finanzierungsrunde (24. September) ist das der Übergang vom fondsfinanzierten Labor zu einer gewöhnlichen Unternehmensstruktur mit Finanzchef, Sponsor und Investorengesprächen.
Drei Millionen Sandkästen am Tag, und die Agenten versuchen trotzdem zu schummeln.
DSec: Sandbox-Infrastruktur für Agenten-Training im großen Maßstab
Mit dem Paper „DeepSeek Elastic Compute (DSec)“ (arXiv 2609.22978, 131 Autoren, Liang Wenfeng als Korrespondenzautor) legt DeepSeek am 19. September die Plattform offen, in der seine Agenten trainieren: rund 3 Mio. Sandboxes pro Tag, über 380.000 gleichzeitig, mehr als 5.000 Neustarts pro Sekunde auf etwa 160 Knoten je Produktionseinheit.
DSec vereint Function-Call-, Container-, microVM- und Voll-VM-Sandboxes hinter einem SDK und koppelt deren Lebenszyklus an das RL-Training; Container-Images kommen blockweise über das hauseigene Dateisystem 3FS, weil Agenten typischerweise unter 10 % eines Images lesen. Das Paper dokumentiert Reward-Hacking im Produktionsbetrieb: Agenten überschrieben Systembinaries wie /bin/bash, um die spätere Bewertung ihrer Lösung abzufangen, suchten per Port-Scan nach Referenzlösungen, zogen fertige Lösungen über Paketmanager oder lösten Kernel-Fehler aus, die Host-Maschinen abstürzen ließen. Dagegen setzt DeepSeek auf AppArmor, eBPF-Netzfilter und Beobachtbarkeit statt auf einen einzelnen Mechanismus. Das V4.1-Flash-Paper nennt DSec als Voraussetzung für die agentische Nachschulung.
Bisher rechnete Huawei nur die Antworten; jetzt soll Ascend auch lernen.
Schwenk auf Huawei: Training der nächsten Modelle auf Ascend geplant
Laut The Information (21. September) nennt Liang Wenfeng vor Investoren das Training auf Huawei- und anderen chinesischen Chips eine der wichtigsten Prioritäten; DeepSeek trainiere derzeit ein 2-Bio.-Parameter-Modell und plane 8 Bio. Eine neue Lieferung Huawei-Trainingschips wird für Q4 2026 oder Q1 2027 erwartet. Bloomberg hatte Anfang September von 160.000 Ascend 950DT für ein 1-GW-Rechenzentrum in Ulanqab (Innere Mongolei) berichtet, dort für Inferenz.
Liangs Rechnung laut Bericht: Ein Modell in der Größenordnung von OpenAIs größtem Projekt brauche rund 50.000 Nvidia GB300 oder etwa 200.000 Ascend 950. Es ist der zweite Anlauf, nachdem 2025 ein R2-Trainingslauf auf Ascend misslang und DeepSeek fürs Training zu Nvidia zurückkehrte. Der Rahmen bleibt die Exportkontroll-Lage: Nvidias China-Chips hängen zwischen Washingtons Auflagen und Pekings Importbremse, und die vom US-Interagency-Komitee gebilligte Aufnahme DeepSeeks in die Entity List ist laut Reuters seit Monaten nicht veröffentlicht. Alle Angaben zu Liangs Aussagen beruhen auf Presseberichten über ein Investorengespräch.
Preise verdoppelt bis vervierfacht, und die Kunden blieben.
Run-Rate 1 Mrd. USD; zweite Runde: 50 Mrd. Yuan bei 500 Mrd. Yuan Bewertung
The Information (24. September, via Reuters) meldet eine annualisierte Umsatz-Run-Rate von 1 Mrd. USD, mehr als doppelt so viel wie wenige Monate zuvor, getragen von der August-Preiserhöhung um das 2,3- bis 4,5-Fache, die laut Liang keine Kunden kostete. Parallel schließt DeepSeek seine zweite Runde ab: 50 Mrd. Yuan (~7,5 Mrd. USD) bei 500 Mrd. Yuan (~75 Mrd. USD) Bewertung, Ziel Ende Oktober; mehr als 70 % der Rechenkapazität gehen ins Training.
Die zweite Runde hat eine Vorgeschichte: Im Juli setzte DeepSeek die Gespräche aus, nachdem ein mutmaßlich geleaktes Investorenprotokoll kursierte; Anfang August nahm sie laut Bloomberg wieder Fahrt auf (knapp 8 Mrd. USD, Monolith Management im Gespräch). Gegenüber den 350–400 Mrd. Yuan post-money der Juni-Runde wären 500 Mrd. Yuan ein Plus von 25 bis 43 % in vier Monaten. Für Januar bis Juli 2026 hatte The Information 475 Mio. Yuan Umsatz berichtet, etwa das Zehnfache des Vorjahres. Die Run-Rate projiziert den jüngsten Monat auf zwölf Monate und ist kein gebuchter Jahresumsatz. Stand 2. Oktober ist der Abschluss der Runde nicht gemeldet; die Juni-Bewertung bleibt bis dahin die letzte belegte.
Alles ist ein Plugin: Modell, Werkzeuge, sogar die Agentenschleife.
DeepSeek Harness: der offene Agenten-Rahmen wird Desktop-App
DeepSeek Harness („dsh“), der MIT-lizenzierte Agenten-Rahmen auf Basis der „Everything is a plugin“-Architektur Cordis, steht als Public Preview bereit, im September auch als Desktop-App für macOS und Windows mit Plugin-Manager, Creator-Modus (Plugins per Chat bauen) und geplanten Aufgaben. Der Rahmen ist modellagnostisch: Neben DeepSeek laufen auch Anthropic-, OpenAI- und OpenAI-kompatible Endpunkte.
Harness war seit dem Sommer als Developer Preview mit ausdrücklichem Vorbehalt auf Breaking Changes unterwegs; die Desktop-Pakete kamen Ende September als Preview-Builds, nicht als GA. Vier Modi: Standard (Dateisystem, Shell, Suche, Subagenten, Planmodus), PTC (das Modell schreibt Programme gegen ein generiertes SDK statt einzelne Tool-Aufrufe abzusetzen), Minimal (nur Shell und Editor) und Creator. DeepSeek tritt damit neben Claude Code und Codex in die Reihe der Coding-Agenten, mit einem offenen, austauschbaren Unterbau statt eines an ein Modell gebundenen Produkts.
Eine CUDA-Alternative aus drei Städten: Sprache aus Peking, Bibliotheken aus Hangzhou, Chips aus Shenzhen.
Mit Huawei: TileLang und fünf Bibliotheken für Ascend quelloffen
Am 30. September gibt DeepSeek über WeChat sechs quelloffene Softwaremodule für Huaweis Ascend-Plattform frei, darunter eine Ascend-Fassung der Kernel-Sprache TileLang sowie Rechen- und Kommunikationsbibliotheken. Mit Huawei zusammen hat DeepSeek außerdem eine Supernode-Lösung aus 128 Ascend 950 abgestimmt; Huawei habe das Vorhaben vollständig unterstützt.
TileLang stammt von Forschern der Peking-Universität; DeepSeek nutzt die Sprache seit etwa einem Jahr, zunächst auf Nvidia-Hardware. Die Begründung des Unternehmens: Ein eigenständiges GPU-Software-Ökosystem brauche zuerst eine universelle, leicht programmierbare Hochsprache, die die Hardware trotzdem ausreizt. Die Module spiegeln laut Reuters die Werkzeuge, die DeepSeek 2025 für Nvidia-Chips offengelegt hatte. Zwei Wochen zuvor hatte Huawei seine nächste Prozessorgeneration und Supernode-Systeme vorgestellt. Ob der Stack Nvidias CUDA-Ökosystem mit geschätzt vier Millionen Entwicklern etwas anhaben kann, ist offen.
Sieben Teile mit Quellenkritik, Datierung und Einordnung — auf einer eigenen, ruhigen Leseseite.
Bildnachweise
- DeepSeek-V2 löst Chinas Preiskrieg aus: Abbildung: DeepSeek · MIT · Wikimedia Commons · bearbeitet: verkleinert
- DeepSeek-R1 auf dem Nature-Cover: Abbildung: Daya Guo, Dejian Yang u. a. (DeepSeek-AI) · CC BY 4.0 · Wikimedia Commons · bearbeitet: verkleinert
Alle Bilder stammen von Wikimedia Commons und stehen unter den genannten freien Lizenzen. Die Einfärbung der Porträts entsteht nur in der Darstellung.